สร้าง Sitemap แล้ว แต่บทความยังไม่ขึ้น Google ต้องส่งใหม่หรือเปล่า? ก่อนกดซ้ำ ให้แยกสามเรื่อง: ไฟล์มี URL ที่ถูกต้องไหม Google อ่านไฟล์ได้ไหม และแต่ละหน้าถูก Index หรือยัง คู่มือนี้พาเช็กตั้งแต่การสร้างจนถึงส่งงาน โดยใช้ Sitemap จริงของ DAYZERO เป็นตัวอย่าง
เริ่มจาก 3 จุดนี้ ก่อนสร้างไฟล์ใหม่
- มีไฟล์อยู่แล้วไหม: ดูเมนู Sitemap ของ CMS หรือ SEO plugin และบรรทัด Sitemap ใน robots.txt ไม่เดาชื่อไฟล์แล้วติดตั้งตัวสร้างเพิ่มทันที
- ใส่หน้าที่ต้องการจริงไหม: เปิดไฟล์ลูกใน sitemap index แล้วค้นหา URL เต็มของหน้าบริการหรือบทความสำคัญ
- Google อ่านได้ไหม: ดูสถานะและวันที่อ่านล่าสุดในรายงาน Sitemap ถ้าอ่านได้แล้ว แต่หน้ายังไม่ Index ให้ตรวจรายงานของ URL นั้นต่อ
ลำดับนี้ช่วยแยกงานของผู้ดูแล CMS ออกจากงานตรวจคุณภาพและการ Index ไม่เสียเวลาแก้ไฟล์ที่ถูกต้องอยู่แล้ว หากยังไม่รู้ภาพรวมของระบบ เริ่มที่ คู่มือ Technical SEO
ต้องการให้ช่วยดู SEO ของเว็บไซต์คุณ? ดู บริการรับทำ SEO ของ DAYZERO
XML Sitemap คืออะไร และช่วย SEO ตรงไหน
XML Sitemap เป็นไฟล์ที่แจ้ง URL ที่เจ้าของเว็บอยากให้เครื่องมือค้นหารู้จัก ส่วน HTML Sitemap เป็นหน้ารวมลิงก์สำหรับคน ทั้งสองอย่างใช้ร่วมกันได้ แต่หน้ารวมลิงก์ไม่ใช่ไฟล์ XML ที่ส่งในรายงาน Sitemap
เว็บไซต์ใหญ่ เว็บใหม่ที่มีลิงก์เข้ามาน้อย หรือเว็บที่ค้นพบเนื้อหาบางส่วนได้ยาก มักได้ประโยชน์จากรายการนี้ เว็บไซต์เล็กที่ทุกหน้าเข้าถึงได้ผ่านลิงก์อาจไม่จำเป็นต้องมี จึงไม่ใช่ข้อบังคับสำหรับการติดอันดับ
ส่งสำเร็จไม่ได้แปลว่า Index ครบ การส่งเป็นการแจ้งตำแหน่งไฟล์ Google ยังต้องตัดสินใจว่าจะ Crawl และ Index หน้าใด การจัดอันดับเป็นขั้นต่อไป ใช้ ลิงก์ภายในที่สอดคล้องกับเนื้อหาร่วมด้วย ไม่ปล่อยบทความสำคัญให้เข้าถึงได้จาก Sitemap อย่างเดียว
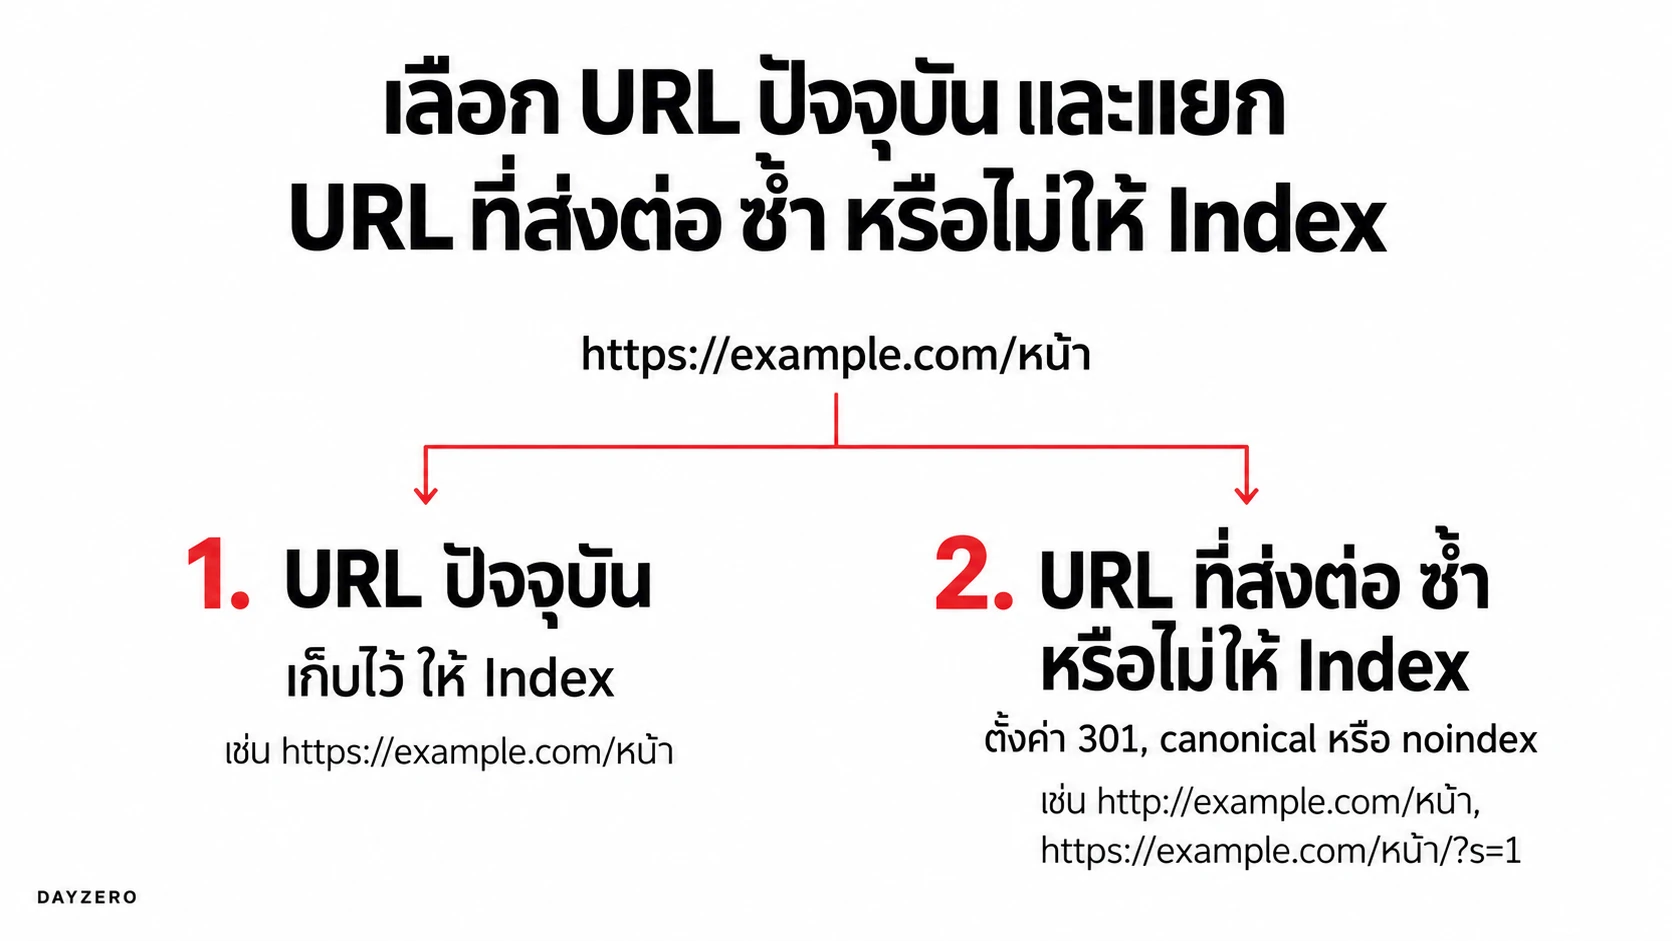
เลือก URL ที่ควรใส่: ไม่ใช่ทุกหน้าที่เปิดได้
เริ่มจากหน้าตัวแทนที่ต้องการให้ปรากฏในผลค้นหา ใช้ URL เต็มพร้อม https และโดเมนที่ถูกต้อง ตรวจหน้าปลายทางจริงว่าใช้งานได้และไม่ถูกตั้งใจปิดการค้นหา การเลือก canonical อ่านต่อได้ใน คู่มือ Canonical, Redirect และ Sitemap
| หน้าแบบไหน | ทำอย่างไร |
|---|---|
| หน้าบริการหรือบทความหลัก | ใส่ URL ตัวแทนที่เปิดได้และต้องการให้ค้นพบ |
| URL เก่าที่ Redirect | ใช้ URL ปลายทางในรายการปัจจุบัน และแก้ตัวสร้างไฟล์ |
| หน้า noindex / ล็อกอิน / 404 | แยกออกจากรายการหน้าที่ต้องการ Index |
| URL ใส่ UTM หรือเวอร์ชันซ้ำ | เลือกตัวแทน ไม่ใส่ทุกเวอร์ชันเพราะอยากเพิ่มจำนวน |
| หน้าที่แปลเนื้อหาหลักจริง | พิจารณา URL ของแต่ละภาษา ไม่รวมเป็น URL เดียวเพียงเพราะพูดเรื่องเดียวกัน |
ตัวอย่างสมมติ: ร้านอาหารมีหน้าเมนูไทยและอังกฤษที่แปลครบ ให้ตรวจสอง URL แยกกัน ส่วนลิงก์เมนูเดียวกันที่ติด UTM ไม่ควรถูกเพิ่มเป็นหน้าใหม่ทุกแคมเปญ การตัดสินใจขึ้นกับเนื้อหาและหน้าที่ของ URL ไม่ใช่จำนวนคำค้นที่คล้ายกัน
สร้าง Sitemap ใน WordPress หรือ CMS โดยไม่ทำซ้ำ
ตรวจระบบที่ใช้อยู่ก่อน CMS หรือ SEO plugin อาจสร้างไฟล์ให้อยู่แล้ว ถ้ามี ให้ใช้ตำแหน่งไฟล์จากการตั้งค่านั้น เปิดดูโดยไม่ล็อกอิน และตรวจว่าประเภทเนื้อหาที่ต้องการอยู่ในไฟล์ลูก อย่าเพิ่ม plugin อีกตัวเพียงเพราะไม่พบชื่อ sitemap.xml
- ระบุว่าใครเป็นตัวสร้างไฟล์ และจด URL ที่ระบบแสดง
- ตรวจว่าบทความหรือหน้าที่เพิ่งเผยแพร่อยู่ในรายการจริง ไม่ใช้แค่สถานะ Published เป็นหลักฐาน
- ถ้าหายไป ตรวจสถานะหน้า การตั้งค่า Index การรวมประเภทเนื้อหา และ cache ของไฟล์
- แก้ที่ตัวสร้างหรือการตั้งค่าที่เกี่ยวข้อง แล้วตรวจไฟล์ที่เสิร์ฟใหม่ ไม่แก้ XML ชั่วคราวที่ระบบจะเขียนทับ
ไม่ต้องติดตั้งอะไรเพิ่มเพื่อทำตามบทความนี้ หากต้องเปลี่ยนระบบบนเว็บจริง ให้ผู้ดูแลทดสอบผลกระทบก่อน รายละเอียด CMS อยู่ใน การตั้งค่า WordPress SEO
ตัวอย่าง XML ขั้นต่ำ และ lastmod ที่ไม่หลอกระบบ
ตัวอย่างนี้ใช้ example.com เพื่ออธิบายโครงสร้าง ไม่ใช่ไฟล์ของ DAYZERO ใส่หนึ่ง URL ในแต่ละ url และต้องมี loc ใช้ namespace 0.9 และบันทึกเป็น UTF-8 ถ้ามี & ใน URL ต้อง escape ให้ถูกต้องใน XML
บนมือถือ เลื่อนกรอบโค้ดแนวนอนเพื่ออ่านทั้งบรรทัด
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://example.com/menu/</loc>
  </url>
</urlset>
lastmod เป็นค่าทางเลือก ถ้าใส่ให้ตรงกับการเปลี่ยนที่มีสาระของหน้านั้น เช่น แก้เนื้อหาหลัก ไม่ใช่วันที่ตัวสร้างเขียนไฟล์ขึ้นใหม่ การเปลี่ยนวันที่ลิขสิทธิ์ไม่ใช่เหตุให้บอกว่าเนื้อหาทุกหน้าอัปเดตแล้ว
Google ไม่ใช้ priority และ changefreq จึงไม่ควรคาดหวังว่า priority 1.0 หรือ changefreq daily จะสั่งให้ Google Crawl ทุกวัน ใช้แรงไปกับ URL ที่ถูกต้องและความน่าเชื่อถือของข้อมูลแทน ข้อกำหนด Google เรื่อง Sitemap
ไฟล์หนึ่งมีได้ไม่เกิน 50,000 URL และ 50 MB ก่อนบีบอัด ถ้าเกินให้แบ่งไฟล์และใช้ sitemap index ชี้ไปไฟล์ลูก การจัดตามภาษา/ประเภทเนื้อหายังช่วยให้ทีมตรวจปัญหาได้ง่ายขึ้น แต่ไม่ใช่สูตรเพิ่มอันดับ
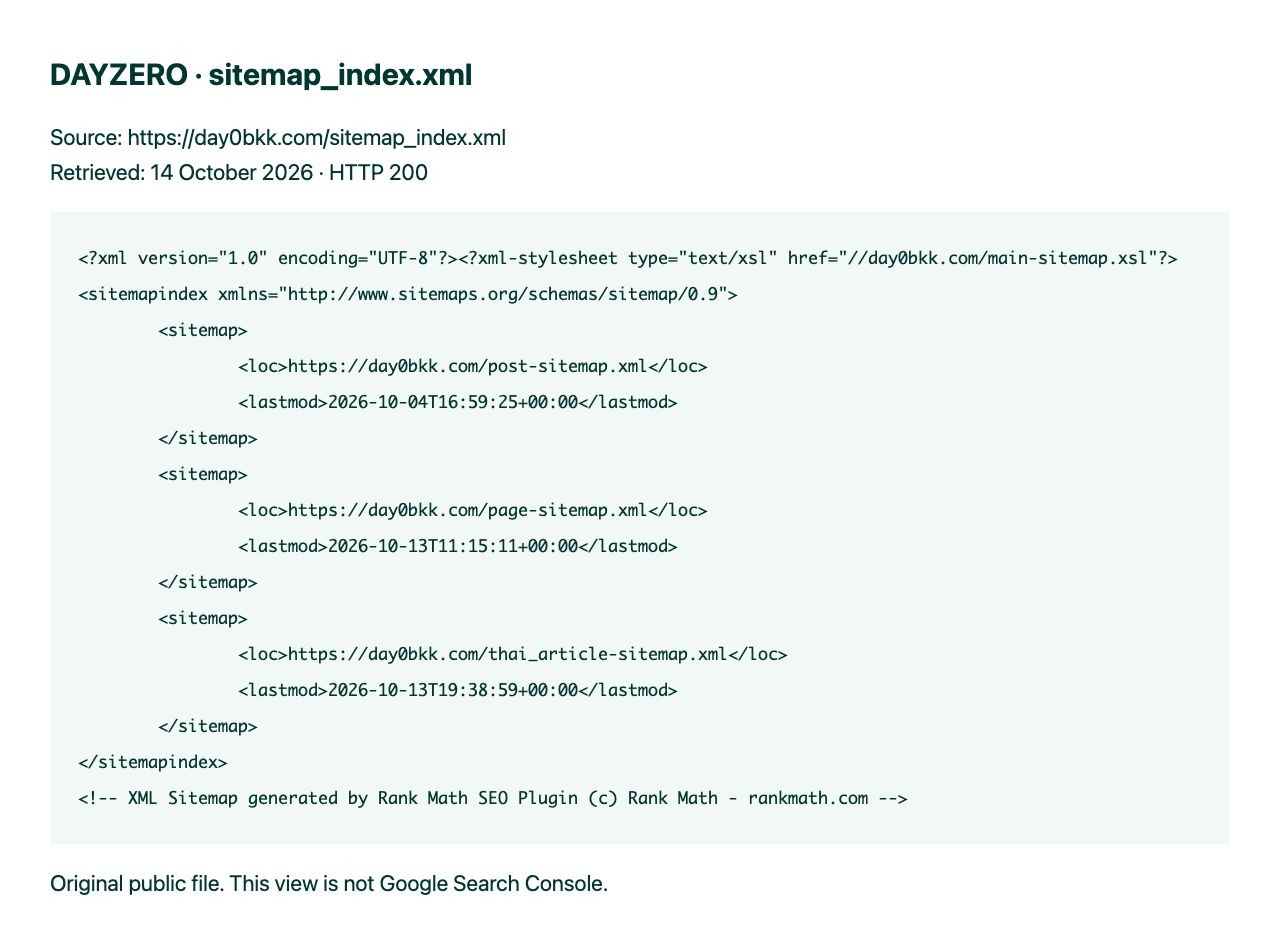
เปิดไฟล์จริงของ DAYZERO: index กับไฟล์ลูก
ตรวจซ้ำวันที่ 20 ตุลาคม 2026: ไฟล์สาธารณะ sitemap_index.xml ของ DAYZERO ได้ HTTP 200 และพบไฟล์ลูกสามรายการ: post-sitemap.xml, page-sitemap.xml และ thai_article-sitemap.xml ชื่อไฟล์จึงไม่ได้เป็น sitemap.xml เสมอไป
จากนั้นเปิด thai_article-sitemap.xml และค้นหา URL ของบทความ Canonical, Redirect และ Sitemap พบอยู่ในรายการ การเปิด index ได้อย่างเดียวไม่บอกว่าหน้าเป้าหมายอยู่ในไฟล์ลูกแล้ว
robots.txt ของเว็บระบุ Sitemap: https://day0bkk.com/sitemap_index.xml ด้วย ทั้งหมดนี้ยืนยันตำแหน่งและรายการที่เผยแพร่ได้เท่านั้น ยังไม่ใช่หลักฐานว่า GSC แสดงสำเร็จ หรือ Google Index ทุกหน้าแล้ว รายการเปลี่ยนได้ตามการเผยแพร่เนื้อหา
วิธีส่ง Sitemap ใน Google Search Console
ต้องมีสิทธิ์ระดับเจ้าของใน property ที่จะส่ง เลือก property ให้ตรงกับเว็บไซต์ โดยเฉพาะเมื่อมี http/https หรือ www/ไม่มี www หลายแบบ การส่งคือแจ้ง URL ของไฟล์ที่เผยแพร่แล้ว ไม่ใช่อัปโหลด XML จากเครื่องเข้า Google
- เปิดไฟล์จริง: ตรวจ URL และการเข้าถึงโดยไม่ล็อกอิน ถ้าจะตรวจจากฝั่ง Google ใช้การทดสอบ URL ที่เผยแพร่ตามคู่มือ Google และดูผลการดึงข้อมูล
- เปิดรายงาน Sitemap: ใน property ที่ถูกต้อง ใส่ตำแหน่งไฟล์ในช่องเพิ่ม Sitemap ใหม่ ตามรูปแบบช่องที่แสดง อย่าซ้ำโดเมนถ้าหน้าจอมี prefix ให้แล้ว
- ส่ง index หรือไฟล์ที่ต้องการ: ถ้าใช้ sitemap index ให้ส่ง URL ของ index ที่ชี้ไปไฟล์ลูกที่ถูกต้อง ไม่ส่ง URL ของบทความแทนไฟล์
- เปิดรายละเอียด: ดูสถานะ วันที่อ่านล่าสุด และข้อผิดพลาด เก็บหลักฐานก่อนถือว่าการส่งเสร็จ
- ตรวจ URL สำคัญต่อ: ใช้ URL Inspection แยกผลของหน้าจริงออกจากสถานะไฟล์
Google อาจอ่านไฟล์ได้แล้วแต่ยังไม่ Crawl ทุก URL ไม่มีจำนวนวันตายตัวที่บทความต้อง Index หากรายงานไม่แสดงไฟล์ที่พบผ่าน robots.txt ก็ไม่ได้แปลว่า Google ไม่รู้จักไฟล์ เพราะรายงานนี้แสดงรายการที่ส่งผ่านรายงานหรือ API คู่มือรายงาน Sitemap
อ่าน Discovered pages อย่างไร เมื่อจำนวนไม่ตรงกัน
Discovered pages คือจำนวน URL ที่ Google อ่านจากไฟล์ ไม่ใช่จำนวนหน้า Index ถ้าเป็น sitemap index จะรวม URL จากไฟล์ลูกและไม่นับ URL ซ้ำ ส่วน Last read คือเวลาที่อ่านไฟล์ ไม่ใช่วันที่ Google เข้าอ่านทุกหน้า ดูคำจำกัดความใน คู่มือรายงาน Sitemaps
ตัวอย่างสมมติ: ทีมมีหน้าที่ต้องการให้ค้นพบ 120 หน้า แต่รายงานแสดง 100 หน้า ยังสรุปไม่ได้ว่าอีก 20 หน้าโดนปฏิเสธ ให้เทียบรายการ URL จริงก่อน ไม่ใช้ผลลบของตัวเลขเป็นรายชื่อหน้าที่มีปัญหา
- หน้าไม่อยู่ในไฟล์: ให้ผู้ดูแล CMS ตรวจการรวมประเภทเนื้อหา สถานะหน้า และ cache
- อยู่ในไฟล์ แต่ไฟล์เปลี่ยนหลัง Last read: บันทึกเวลาและรอดูรอบอ่านใหม่ แยกจากกรณีอ่านไม่ได้
- อ่านไฟล์แล้ว: เปิดรายงาน Page indexing กรองตาม Sitemap และใช้ URL Inspection กับหน้าสำคัญ เพื่อดูเหตุผลรายหน้า
บันทึกแยกสามค่า: จำนวน URL เป้าหมายของทีม / จำนวนที่อ่านจาก Sitemap / จำนวนที่ Index พร้อมวันที่และขอบเขตเดียวกัน หน้าสินค้าที่ตั้งใจไม่นำเข้าผลค้นหาไม่ควรถูกนับเป็นงานค้างเพียงเพื่อให้ยอดเท่ากัน
Sitemap Error: แก้ตามจุดที่หยุด ไม่กดส่งซ้ำอย่างเดียว
ดึงข้อมูลไม่ได้
ตรวจ URL ที่ส่งและ property ก่อน แล้วดู HTTP status, timeout, การล็อกอิน และการเข้าถึงจาก Google ไม่สรุปว่าระบบ Google ผิดเพียงเพราะเราเปิดได้จากเครื่องเดียว ส่งรายละเอียดให้ทีม server/CDN ตรวจข้อจำกัดที่เกี่ยวข้อง ไม่ปิดระบบป้องกันทั้งหมดเพื่อแก้เร็ว
ถ้า URL ของไฟล์ที่ส่งเปลี่ยนทางไปอีก URL ให้ส่งปลายทางจริงโดยตรง รายงาน Sitemaps ไม่ตาม Redirect ของ URL ไฟล์ที่ส่ง กรณีนี้ต่างจากการตรวจ URL ของหน้าเว็บที่อยู่ข้างในไฟล์
อ่านได้ แต่ XML มีข้อผิดพลาด
เปิดรายละเอียดข้อผิดพลาด ตรวจแท็กปิด namespace ตัวอักษร escape และ URL ที่ไม่ครบ ถ้าใช้ index ให้แยกตรวจแต่ละไฟล์ลูก แก้ตัวสร้างที่ทำให้ไฟล์ผิด แล้วเปิดไฟล์สาธารณะใหม่ก่อนส่งอีกครั้ง
วันที่ผิด หรือ URL ภาษาไทยเปิดแล้วไม่ตรงหน้า
ถ้าเจอ Invalid date ให้ตรวจรูปแบบ เช่น 2026-10-20 หรือ 2026-10-20T14:00:00+07:00 ตัวอย่างหลังเป็นเวลาไทยสมมติ ถ้าเก็บเวลาเป็น UTC ต้องแปลงให้ตรง ไม่เติม Z ต่อท้ายเวลาไทยเฉย ๆ และไม่เปลี่ยน lastmod ทั้งเว็บให้เป็นวันนี้โดยไม่มีการแก้เนื้อหา
ถ้าใช้ slug ภาษาไทย ให้ตรวจ URL หลังนำออกจาก XML ว่าเปิดหน้าที่ตั้งใจได้ ระบบควรจัดการ UTF-8 และ URL encoding ให้ถูก อย่า encode ซ้ำจนเครื่องหมาย % กลายเป็น %25 ส่วน & ในข้อมูล XML ต้องเขียนเป็น & ตาม ข้อกำหนด Sitemaps.org การเปลี่ยนวิธีเขียนใน XML ไม่ใช่เหตุให้เปลี่ยน URL บทความที่เผยแพร่แล้ว
สำเร็จ แต่บางหน้ายังไม่ Index
ไม่สร้าง Sitemap อีกชุดเพื่อหวังบังคับ Index ตรวจหน้าจริงว่าตอบกลับอย่างไร มี noindex หรือไม่ Google เลือก canonical อะไร และเนื้อหาต่างจากหน้าอื่นอย่างมีประโยชน์ไหม ดู วิธีแยกเหตุผลที่หน้าไม่ Index และ ความต่างของ robots.txt กับ noindex
สถานะสำเร็จหมายถึง Google ดึงและอ่าน Sitemap ได้โดยไม่มีข้อผิดพลาด ไม่ได้บอกว่าทุก URL ได้รับการจัดอันดับ การตัดสินใจขั้นถัดไปจึงต้องอ้างอิง URL ไม่ใช้แค่สีเขียวของรายงานไฟล์
อัปเดตเมื่อเพิ่มหน้า ย้าย URL หรือทำหลายภาษา
หลังเผยแพร่หน้าใหม่ ตรวจว่าระบบเพิ่ม URL ที่เลือกแล้ว หลังย้าย URL ตรวจรายการใหม่พร้อม redirect และลิงก์ภายใน หากไฟล์ที่ Google เคยอ่านสำเร็จอัปเดตตามปกติ ไม่ต้องกดส่งซ้ำทุกครั้งเพื่อให้ดูเหมือนทำงาน Google อ่าน Sitemap ซ้ำตามรอบของระบบ การเปลี่ยนสำคัญหรือการแก้ข้อผิดพลาดอาจเป็นเหตุให้ส่งใหม่ได้
ไม่ใช้คำสั่ง ping แบบเก่าเพื่อแจ้ง Google อีกแล้ว Google ยุติ endpoint นี้แล้ว การตอบกลับ 404 ของ endpoint เก่าไม่ได้แปลว่าไฟล์ Sitemap ของเว็บเสีย ใช้ Search Console หรือการระบุไฟล์ใน robots.txt ตามวิธีปัจจุบัน
เว็บไทยที่มีอังกฤษหรือญี่ปุ่น ให้ตรวจ URL ของแต่ละภาษาและความสอดคล้องกับ canonical หากใช้ hreflang ผ่าน XML ต้องจัดคู่ภาษาให้ถูกตามข้อกำหนด ส่วนเว็บไซต์ที่ใช้ hreflang ใน HTML อยู่แล้ว ไม่ควรเพิ่มข้อมูลอีกชุดที่ขัดกันเพียงเพื่อให้ครบทุกวิธี อ่าน คู่มือ hreflang
กำหนดเจ้าของงานให้ชัด: ทีม CMS ดูตัวสร้าง ทีม SEO เลือกหน้าปัจจุบันและตรวจผล ส่วนผู้อนุมัติรับงานจากไฟล์จริงและหลักฐาน GSC ไม่รับเพียงข้อความว่า “ติดตั้ง plugin แล้ว”
เช็กลิสต์รับงาน: เก็บอะไรไว้หลังแก้
- URL ของ index และไฟล์ลูกที่ใช้จริง พร้อมผู้ดูแลตัวสร้าง
- หลักฐานเปิดไฟล์ได้ รายการ URL เป้าหมาย และวันที่ตรวจ
- การตรวจ URL ตัวแทน สถานะหน้า และความสอดคล้องของลิงก์ภายใน
- property สถานะ วันที่อ่าน และ error ใน GSC หรือระบุว่ายังไม่ได้ตรวจ
- ผล URL Inspection ของหน้าสำคัญ แยกจากผลอ่าน Sitemap
- รายการปัญหาค้าง ผู้รับผิดชอบ และสิ่งที่จะตรวจครั้งถัดไป
ตัวอย่าง DAYZERO ในบทความนี้ตรวจไฟล์สาธารณะแล้ว แต่ไม่ได้ใช้เป็นคำรับรองผล Index ให้ลูกค้า เมื่อรับงานจริงต้องเก็บสถานะของเว็บไซต์นั้นในวันที่ตรวจ ไม่ยืมภาพผลลัพธ์ของเว็บอื่นมาแทน
คำถามที่พบบ่อยเรื่อง XML Sitemap
ไฟล์ชื่อ sitemap.xml เท่านั้นหรือ?
ไม่จำเป็น ใช้ URL ที่ระบบสร้างจริง ตัวอย่าง DAYZERO ใช้ sitemap_index.xml ชี้ไปไฟล์ลูก
ลบ URL ออกจาก Sitemap แล้วจะหายจาก Google ไหม?
ไม่ใช่การสั่งลบผลค้นหา Google อาจรู้จัก URL ผ่านลิงก์อื่นอยู่ หากต้องการนำหน้าออกต้องเลือกวิธีให้ตรงเป้าหมาย ไม่ใช้การลบจากรายการแทน noindex หรือการนำหน้าลง
ต้องส่งใหม่ทุกวันไหม?
ไม่มีหน้าที่ต้องส่งทุกวัน ไฟล์ที่อ่านสำเร็จจะถูกอ่านซ้ำตามรอบของ Google ตรวจความถูกต้องและแก้ข้อผิดพลาดก่อนคิดเรื่องกดซ้ำ
ใส่ทุกรูปลง Image Sitemap แล้วอันดับจะเพิ่มไหม?
ส่วนขยายช่วยแจ้งข้อมูลรูปภาพ แต่ไม่รับรองอันดับ ใช้ตามประเภทเนื้อหาและปัญหาการค้นพบจริง การจัดการรูปอ่านต่อใน คู่มือ Image SEO
แหล่งอ้างอิงและวันที่ตรวจ
- Google: สร้างและส่ง Sitemap
- Google: รายงาน Sitemap และข้อผิดพลาด
- Sitemaps.org: โครงสร้าง XML
- Google: เมื่อใดควรใช้ Sitemap
- Google: เวอร์ชันภาษา
- Google: Image Sitemap
ทบทวนเอกสารและตรวจไฟล์สาธารณะซ้ำวันที่ 20 ตุลาคม 2026 ส่วนภาพบันทึกวันที่ 14 ตุลาคม 2026 ภาพไฟล์ DAYZERO แสดงข้อความต้นฉบับที่บันทึกและเปิดให้อ่าน แผนภาพสร้างด้วย GPT ตัวอย่าง XML ใช้โดเมนสมมติ การเข้าถึงไฟล์ไม่ใช่หลักฐาน Index หรืออันดับ
มี Sitemap แล้ว แต่ยังไม่รู้ว่าติดปัญหาตรงไหน?
ส่ง URL ของ Sitemap หน้าที่อยากให้ค้นพบ และสถานะล่าสุดใน Search Console เพื่อเริ่มตรวจจากจุดที่มีหลักฐาน แล้ววางลำดับแก้ร่วมกับทีมเว็บไซต์ บริการ SEO ของ DAYZERO