จะกัน Google เข้าอ่าน หรือแค่ไม่ให้หน้าแสดงในผลค้นหา? Robots.txt กับ noindex ทำคนละงาน หากใช้ผิด Google อาจอ่านหน้าบริการไม่ได้ หรือยังแสดง URL ที่ต้องการนำออก คู่มือนี้มีไฟล์จริงของ DAYZERO วิธีตรวจ WordPress และหลักฐานที่ต้องเก็บหลังแก้
Robots.txt กับ noindex ต่างกันตรงไหน
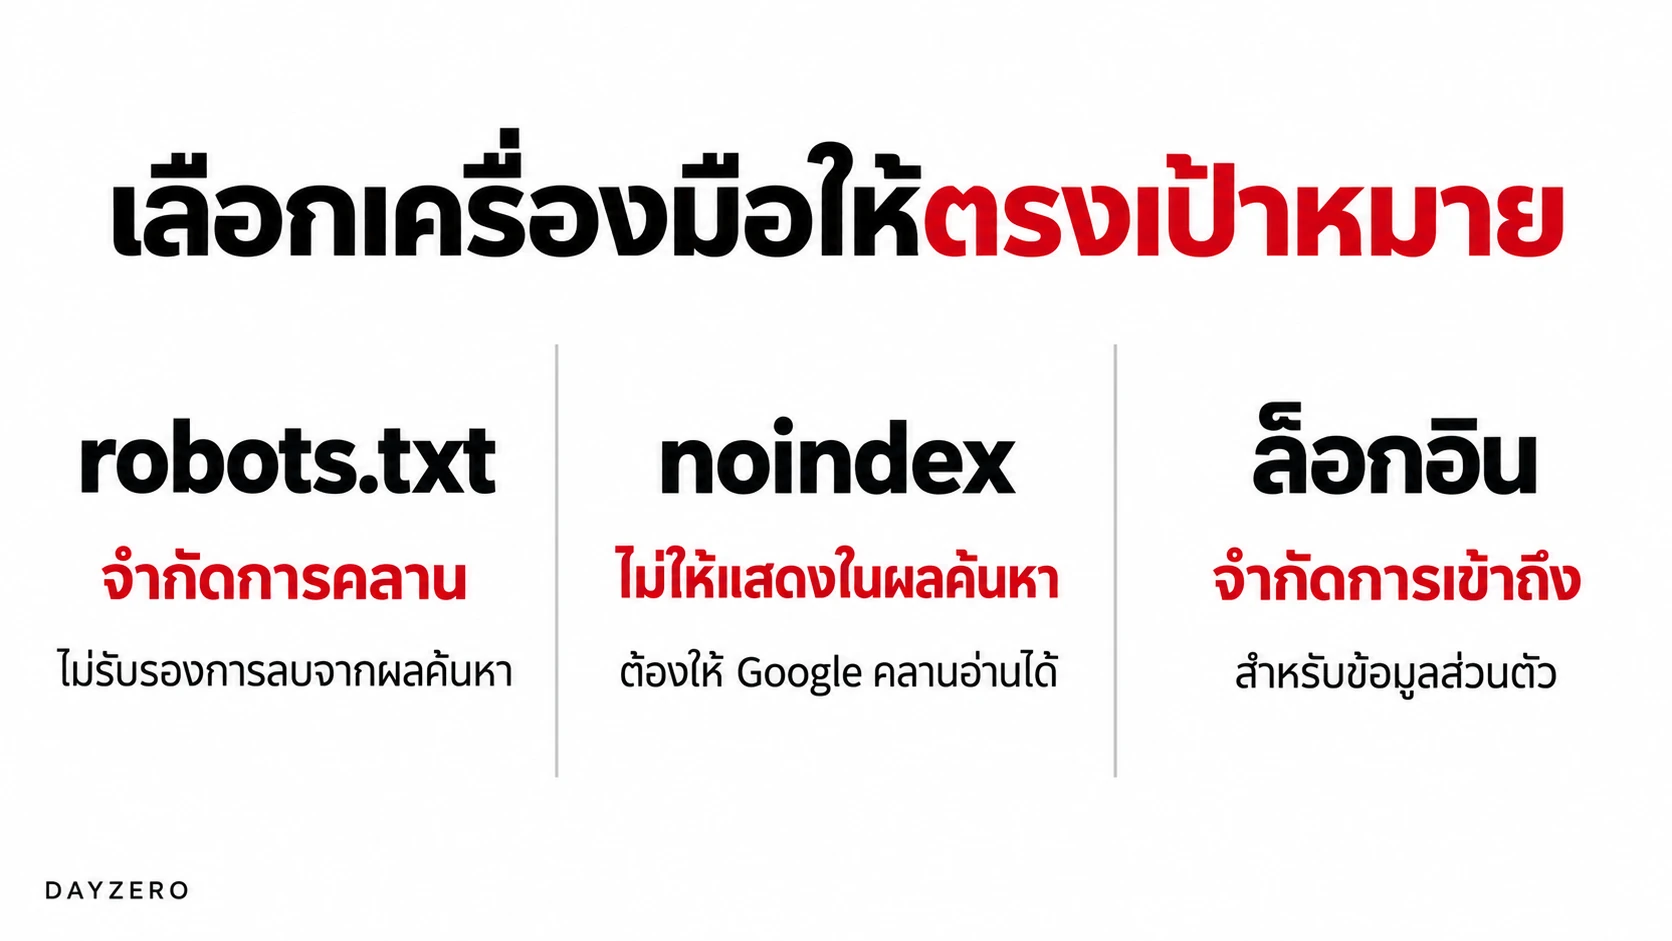
Robots.txt ควบคุมการ Crawl ส่วน noindex บอกไม่ให้หน้าหรือทรัพยากรอยู่ในผลค้นหาของเครื่องมือที่รองรับ Google ต้องเข้าถึงหน้าเพื่ออ่าน noindex จึงไม่ควรบล็อกทางเข้าที่จำเป็นด้วย robots.txt พร้อมกัน
- ต้องให้ลูกค้าค้นหน้าบริการ: ตรวจว่าหน้าเปิดได้ ไม่ถูกบล็อกโดยไม่ตั้งใจ และไม่มี noindex ที่ผิด
- หน้าเปิดให้คนอ่าน แต่ไม่ต้องการใน Search: เลือก noindex ที่ Google อ่านได้
- ต้องจัดการการ Crawl ที่ไม่จำเป็น: พิจารณา robots.txt ตาม URL และพฤติกรรมจริง
- ข้อมูลเฉพาะคนมีสิทธิ์: ใช้ระบบควบคุมการเข้าถึง ไม่ใช้ robots.txt หรือ noindex เป็นรหัสผ่าน
อ่านภาพรวมใน Technical SEO สำหรับตรวจเว็บไซต์ ถ้าปัญหาคือหน้าไม่เข้า Google แต่ยังไม่รู้เหตุ ให้เริ่ม ตรวจสถานะไม่ Index ใน Search Console ก่อนเปลี่ยนการตั้งค่า
ต้องการให้ช่วยดู SEO ของเว็บไซต์คุณ? ดู บริการรับทำ SEO ของ DAYZERO
Robots.txt อยู่ที่ไหน และกฎมีผลกับ URL ใด
ไฟล์อยู่ที่เส้นทาง /robots.txt ของโฮสต์และโปรโตคอลที่ใช้ เช่น https://example.com/robots.txt ไม่ใช่ /th/robots.txt เพียงเพราะบทความเป็นไทย โดยไฟล์ที่รากของโฮสต์เดียวกันอาจกำหนดเส้นทาง /th/ ได้
www กับโดเมนไม่มี www, โดเมนย่อย, http กับ https และพอร์ตอาจมีขอบเขตต่างกัน ตรวจที่อยู่ปลายทางจริง ไม่สรุปว่าไฟล์ฝั่ง http “ใช้ไม่ได้” ทุกกรณี
User-agent: เลือก Crawler ที่กฎใช้ เช่น Googlebot หรือกลุ่มทั่วไป*Disallow: ระบุเส้นทางที่ไม่ให้ CrawlAllow: ยกเว้นให้ Crawl เส้นทางที่ระบุSitemap: ระบุ URL เต็มของ sitemap ไม่ใช่คำสั่งให้ Index ทุกหน้าทันที
สำหรับ Google ต้องเลือกกลุ่ม User-agent และเส้นทางที่ตรง URL จริง กฎที่เฉพาะกว่าจะสำคัญกว่าการอ่านแค่บรรทัดแรก ตัวพิมพ์ของเส้นทางก็มีผล ดู ข้อกำหนด robots.txt ของ Google เมื่อใช้กฎหลายกลุ่มหรือ wildcard อย่าเพิ่มกฎที่ไม่เข้าใจเพื่อให้ดูครบ
กฎด้านล่างไม่ได้ชนะเสมอ
Google เลือกกลุ่มที่ตรงกับชื่อบอทเฉพาะที่สุดก่อน กลุ่มเฉพาะอย่าง User-agent: Googlebot ไม่ถูกรวมกับกลุ่มทั่วไป * แต่ถ้ามีกลุ่มเฉพาะชื่อเดียวกันหลายกลุ่ม Google รวมกฎของกลุ่มเหล่านั้น ดังนั้นการเพิ่มกลุ่ม Googlebot ที่มีแค่ Allow: / อาจทำให้ข้อห้ามในกลุ่มทั่วไปไม่ถูกใช้กับ Googlebot
ภายในกลุ่มที่ใช้ ให้พิจารณาความเฉพาะของเส้นทางตามความยาว ไม่ใช่ตำแหน่งบรรทัด ถ้า Allow กับ Disallow ขัดกันโดยเฉพาะเท่ากัน Google เลือกกฎที่จำกัดน้อยกว่า ตัวอย่างสมมติ:
User-agent: *
Disallow: /demo/
Allow: /demo/help/
/demo/help/start/ เปิดให้ Crawl ตามข้อยกเว้นที่เจาะจงกว่า แต่ /demo/other/ ยังถูกบล็อก ระวัง /demo ที่ไม่มีเครื่องหมายปิดท้าย เพราะอาจตรงกับ /demo-news/ ด้วย ทดสอบทั้ง URL ที่ต้องบล็อกและที่ต้องเปิดก่อนใช้กฎจริง
ตัวอย่าง robots.txt จริงของ DAYZERO
วันที่ 20 ตุลาคม 2026 ตรวจซ้ำ robots.txt สาธารณะของ DAYZERO ได้ HTTP 200 และชนิด text/plain ข้อความที่ได้รับมีดังนี้ ไม่ได้แก้ไฟล์เพื่อทำตัวอย่าง:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://day0bkk.com/sitemap_index.xml
กลุ่มทั่วไปจำกัด Crawl ใต้ /wp-admin/ แต่มีข้อยกเว้นสำหรับ admin-ajax.php และแจ้งตำแหน่ง sitemap ในไฟล์นี้ไม่มีคำสั่ง noindex
นี่เป็นตัวอย่างไฟล์ ไม่ใช่แม่แบบให้คัดลอกทุกเว็บ เว็บไซต์อื่นอาจมีระบบและเส้นทางต่างกัน การดึงไฟล์ได้ 200 ยังไม่พิสูจน์ว่าทุกหน้าสำคัญ Crawl ได้หรือ Google ประมวลผลเวอร์ชันนี้แล้ว ต้องตรวจ URL เป้าหมายแยกด้วย
ตั้ง noindex: Meta tag หรือ HTTP header
HTML ใช้แท็กใน <head> เช่น <meta name="robots" content="noindex"> ข้อความโค้ดที่แสดงเพื่ออธิบายอย่างในบทความนี้ไม่ใช่แท็กที่ทำงาน อย่าให้ระบบส่งแท็ก noindex จริงในหน้าที่ต้องค้นพบ Google อาจทำตามแท็กจริงแม้อยู่ใน body แต่ตำแหน่งที่แนะนำให้จัดการคือ head ส่วนไฟล์ที่ไม่ใช่ HTML เช่น PDF ใช้ HTTP header X-Robots-Tag: noindex ได้ตามระบบที่ให้บริการไฟล์
Google ไม่รองรับการเขียน Noindex: ลง robots.txt และ nofollow เป็นคำสั่งคนละเรื่อง ไม่ต้องใส่ร่วมเสมอเพียงเพราะเห็นตัวอย่างในเว็บอื่น
ตาม แนวทาง noindex ของ Google หน้าและทรัพยากรต้องเข้าถึงได้เพื่อให้ Google อ่านคำสั่ง การเพิ่ม noindex แล้วบล็อกหน้าเดียวกันด้วย Disallow อาจทำให้ Google ไม่เห็นคำสั่งที่เพิ่งเพิ่ม
ถ้าเป็นหน้าที่มีข้อมูลส่วนตัว ให้แก้การเข้าถึงข้อมูลเป็นงานหลักก่อน ไม่เปิดข้อมูลเพื่อให้ Google อ่าน noindex การนำออกจากผลค้นหาและการป้องกันผู้ไม่มีสิทธิ์เข้าถึงเป็นคนละเป้าหมาย
ถ้ามีคำสั่งที่ขัดกัน Google ใช้คำสั่งที่จำกัดมากกว่า จึงต้องตรวจทั้ง meta และ header ไม่ดูเฉพาะช่อง Index ที่ติ๊กไว้ในปลั๊กอิน
ตรวจบน WordPress: ค่าที่ตั้งกับหน้าที่ส่งจริง
ก่อนแก้ ดูว่าใครกำหนดค่าอยู่: WordPress, ปลั๊กอิน SEO, ธีม หรือเซิร์ฟเวอร์ การมีหลายที่กำหนดคำสั่งอาจทำให้ค่าที่หน้าส่งออกต่างจากช่องที่กำลังดู
- เปิดบทความเป้าหมายและดูการตั้งค่า Robots ของปลั๊กอินที่ใช้อยู่ ไม่เปิดปลั๊กอินตัวใหม่ซ้อนเพื่อเพิ่มปุ่ม
- ยืนยันกับเจ้าของเนื้อหาว่าหน้านี้ต้องปรากฏใน Search หรือไม่ แล้วตรวจว่าค่าระดับหน้าใช้ค่าเริ่มต้นหรือกำหนดเฉพาะ
- หลังบันทึก เปิด URL สาธารณะและตรวจ robots meta รวมถึง HTTP header ไม่ตรวจแค่ภาพช่องติ๊ก
- ถ้าข้อมูลยังเก่า ตรวจแคชและเทมเพลตที่เกี่ยวข้อง แล้วจึงทดสอบใหม่
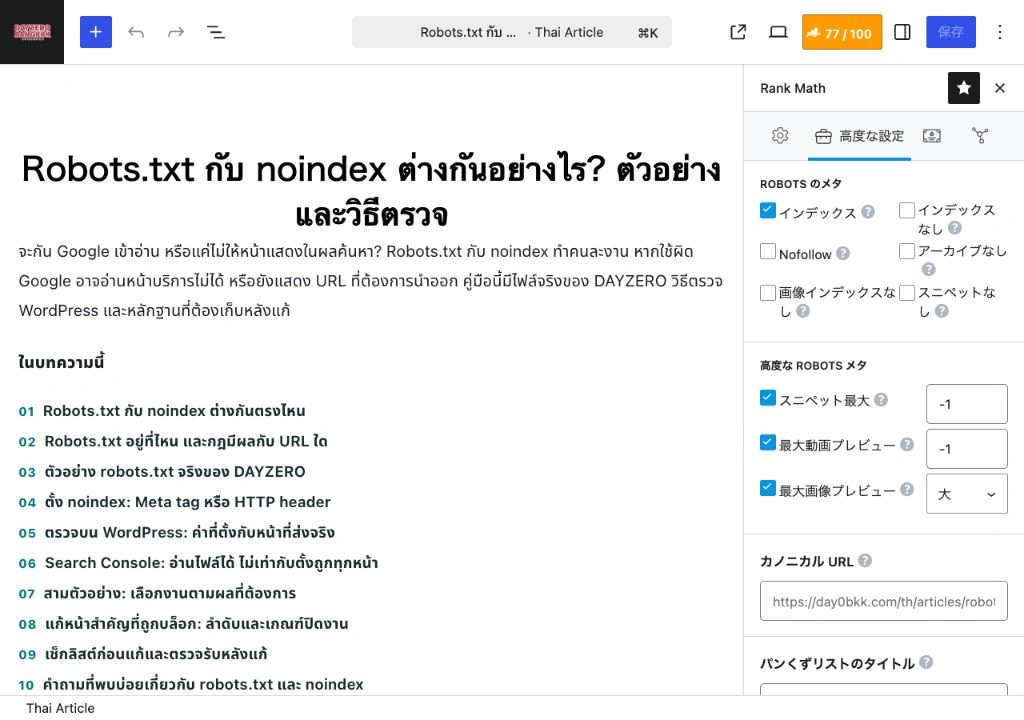
ชื่อเมนูต่างกันตามปลั๊กอิน เวอร์ชันและภาษา ภาพของ DAYZERO ใช้ Rank Math ในเมนูญี่ปุ่น: Index กับ No Index เป็นตัวเลือกที่ต้องดู ไม่ได้หมายความว่าบทความที่เผยแพร่เป็นภาษาญี่ปุ่น
อย่าเปลี่ยนค่าระดับทั้งเว็บไซต์เพื่อแก้หน้าเดียว และอย่าปิดการควบคุมการเข้าถึงข้อมูลส่วนตัว ดู การตรวจ SEO บน WordPress สำหรับระบบอื่นที่ควรตรวจร่วมกัน
Search Console: อ่านไฟล์ได้ ไม่เท่ากับตั้งถูกทุกหน้า
รายงาน robots.txt บอกไฟล์ที่ Google พบ วันที่ดึงข้อมูล ปัญหาและเวอร์ชันที่ดึงไว้ ตาม เอกสารรายงาน robots.txt ใช้พร็อพเพอร์ตี้โดเมน หรือ URL-prefix ที่ไม่มีเส้นทาง เช่น https://example.com/ ถ้าใช้พร็อพเพอร์ตี้ /th/ แล้วไม่เห็นรายงาน ให้ตรวจประเภทพร็อพเพอร์ตี้ก่อนสรุปว่าไฟล์หาย
สถานะ “ดึงข้อมูลแล้ว” บอกว่าคำขอล่าสุดได้ไฟล์ ไม่ได้บอกว่า Disallow ตรงเป้าหมายทั้งหมด อ่านปัญหาการแยกวิเคราะห์และเทียบเวอร์ชันกับไฟล์ที่เผยแพร่จริงด้วย การไม่มี robots.txt ไม่ใช่ข้อผิดพลาด SEO ทุกกรณี
จากนั้นตรวจ URL สำคัญด้วย URL Inspection: อนุญาต Crawl หรือไม่ อนุญาต Index หรือไม่ วันที่ข้อมูลและสิ่งที่ Google มีอยู่ ถ้าเพิ่งแก้ ใช้ Live test ในส่วนที่ทดสอบได้ แต่ไม่ใช้ผลผ่านเป็นหลักฐานว่า Index สำเร็จแล้ว
ไฟล์ตอบ 404 กับ 500 ต้องแก้ต่างกัน
ตาม ข้อกำหนดปัจจุบันของ Google ถ้า URL ของ robots.txt ตอบ 4xx เช่น 404 หรือ 403 ยกเว้น 429 Google ถือว่าไม่มีข้อจำกัด Crawl จากไฟล์นี้ จึงอย่าใช้ 403 ของไฟล์ robots.txt เป็นวิธีปิดบอท
แต่ถ้าดึง robots.txt ไม่ได้เพราะ 5xx หรือปัญหาเครือข่าย Google อาจหยุด Crawl ช่วงแรกและใช้ฉบับที่เก็บไว้ภายหลัง ให้ทีมโฮสติ้งหรือผู้ดูแล CDN ตรวจการตอบกลับของไฟล์ก่อน ไม่แก้ด้วยการเพิ่ม Keyword หรือส่ง Sitemap ซ้ำ กติกานี้กล่าวถึง URL ของ robots.txt โดยเฉพาะ ไม่ใช่ว่าหน้าเนื้อหาที่ตอบ 403 จะอ่านได้ตามปกติ
การขอ Crawl ไฟล์ robots.txt ใหม่กับการขอจัดทำดัชนีหน้าเว็บเป็นคนละคำขอ ไม่จำเป็นต้องส่งใหม่ทุกวัน และไม่รับประกันวันที่หน้าเริ่มแสดง
สามตัวอย่าง: เลือกงานตามผลที่ต้องการ
ตัวอย่างสมมติ ไม่ใช่เหตุการณ์หรือผลลูกค้า:
หน้าบริการที่มี noindex โดยไม่ตั้งใจ
เจ้าของบริการยืนยันว่าต้องให้ค้นพบ ทีมเว็บตรวจแหล่งคำสั่งและแก้เฉพาะ URL หรือเทมเพลตที่ผิด ตรวจหน้าเป้าหมายและหน้าที่ตั้งใจไม่แสดง จากนั้นติดตามข้อมูล Google แยก ไม่รับรองว่าปลดแล้วอันดับกลับทันที
บทความสาธารณะที่ไม่ต้องการให้ค้นหา
กำหนด noindex ที่ Google อ่านได้ ไม่เพิ่ม Disallow ของหน้าเดียวกันเพื่อ “กันสองชั้น” แล้วบันทึกวันที่เปลี่ยน เทียบวันที่ Crawl และผลดัชนีภายหลัง
เอกสารสำหรับลูกค้าที่มีสิทธิ์
ใช้ระบบยืนยันตัวตนและสิทธิ์เป็นหลัก ไม่ใส่ชื่อเส้นทางลง robots.txt แล้วถือว่าเอกสารถูกซ่อน หากมีสำเนาสาธารณะ ต้องตรวจการเผยแพร่และการนำออกเป็นงานแยก
แก้หน้าสำคัญที่ถูกบล็อก: ลำดับและเกณฑ์ปิดงาน
ถ้าหน้าบริการที่ควรรับลูกค้าถูกบล็อก ให้เก็บ URL และเหตุผลที่ Search Console แสดง แล้วทำตามลำดับนี้ โดยไม่เปลี่ยนทั้งเว็บไซต์เพื่อแก้หน้าเดียว
- ระบุแหล่งปัญหา: แยกว่าเป็น Disallow, meta noindex, X-Robots-Tag หรือไฟล์ robots.txt ดึงไม่ได้ ตรวจเวลาที่ Google เก็บข้อมูลด้วย
- แก้จุดที่สร้างคำสั่ง: ผู้ดูแลเว็บแก้ไฟล์ ปลั๊กอิน เทมเพลต หรือเซิร์ฟเวอร์ที่เป็นต้นทาง เก็บค่าก่อนแก้ และตรวจว่าแคชไม่ส่งฉบับเดิม
- ตรวจหน้าสาธารณะซ้ำ: URL เป้าหมายเปิดได้ ข้อห้ามที่ไม่ตั้งใจหายไป และหน้าที่ต้องป้องกันยังมีการควบคุมตามเดิม อย่าถอดระบบล็อกอินของข้อมูลส่วนตัวเพื่อทำให้ Crawl ผ่าน
- แยกคำขอ: ถ้าแก้กฎสำคัญของ robots.txt ใช้ Request a recrawl ในรายงานไฟล์นั้น ส่วนหน้าเนื้อหาใช้ URL Inspection ตรวจ Live test และขอ Indexing เมื่อพร้อมตามเครื่องมือที่แสดง
- ติดตามหลัง Google อ่านใหม่: บันทึกวันที่ Crawl และสถานะ Index ภายหลัง การทดสอบผ่านเพียงยืนยันสิ่งที่ทดสอบได้ ณ ตอนนั้น ไม่รับรองอันดับหรือวันที่กลับมาแสดง
ในใบส่งงานให้มี 3 สถานะแยกกัน: แก้เว็บไซต์แล้ว → Google อ่านฉบับใหม่แล้ว → ผลค้นหาเปลี่ยนแล้ว หากยังอยู่ขั้นแรก อย่ารายงานว่าแก้ SEO สำเร็จทั้งหมด และถ้า Google อ่านได้แล้วแต่ยังไม่ Index ให้ตรวจคุณค่าเนื้อหา หน้าซ้ำ และลิงก์ตาม คู่มือหน้าไม่ถูก Index ต่อ ไม่เปิด–ปิด noindex ซ้ำเพื่อเร่งผล
เช็กลิสต์ก่อนแก้และตรวจรับหลังแก้
- ก่อนแก้: เก็บ URL, เป้าหมายให้ค้นพบหรือไม่, กฎเดิม, วันเวลาและแหล่งกำหนดค่า เก็บฉบับเดิมเพื่อคืนค่า
- ขอบเขต: ระบุหน้าเดียวหรือกลุ่มเทมเพลต พร้อมตัวอย่างที่ควรและไม่ควรถูกกระทบ
- หลังแก้เว็บไซต์: ตรวจไฟล์ robots ที่โฮสต์จริง meta/header ของหน้า และเนื้อหาที่ผู้ใช้เห็น ตรวจ CSS/JS สำคัญที่ต้องให้ Google เข้าใจหน้า
- หลัง Google อ่านใหม่: เทียบวันที่และเหตุผลใน Search Console โดยแยกการอ่านไฟล์ การอ่านหน้าและการจัดทำดัชนี
- ผลธุรกิจ: ถ้ามีข้อมูล จึงตรวจการค้นพบ คลิกและสอบถาม ไม่ใช้การบันทึกการตั้งค่าเป็นหลักฐานว่าอันดับหรือยอดขายเพิ่ม
ถ้าปัญหาอยู่ที่ URL ตัวแทนหรือการย้ายหน้า ให้อ่าน canonical, redirect และ sitemap ไม่ใช้ noindex แทนการกำหนดหน้าหลัก และถ้ากระทบหลายเรื่อง ใช้ SEO Audit เพื่อจัดลำดับงาน ให้ทีมเห็นงานที่ต้องแก้ก่อน
คำถามที่พบบ่อยเกี่ยวกับ robots.txt และ noindex
Disallow แล้วทำไม URL ยังอยู่บน Google?
Google อาจรู้จัก URL จากลิงก์ภายนอกแม้ไม่ได้อ่านเนื้อหา robots.txt ไม่รับรองว่าหน้า HTML จะหายจาก Search
ต้องมี robots.txt เพื่อให้ติดอันดับไหม?
ไม่ใช่ข้อบังคับอันดับ ตัดสินจากระบบและความจำเป็นของการควบคุม Crawl ไม่เพิ่มไฟล์เพียงเพื่อให้เช็กลิสต์ครบ
noindex ช่วยเพิ่มอันดับหน้าอื่นแน่นอนหรือไม่?
ไม่รับรอง เลือกจากหน้าที่ไม่ต้องการในผลค้นหาและคุณค่าที่หน้าให้ ไม่ตัดบทความทั้งหมดเพียงเพราะยอดเข้าชมต่ำ
เว็บเปิดได้แต่ Google เข้าไม่ได้ เป็นไปได้ไหม?
เป็นไปได้ ตรวจกฎ Crawler การตอบกลับและหลักฐานของ Google ไม่ใช้การเปิดตอนล็อกอินเป็นหลักฐานแทนทุกขั้น
แก้แล้วต้องรอกี่วัน?
ไม่มีเวลาตายตัว Google ต้องอ่านข้อมูลใหม่ บันทึกวันแก้และวัน Crawl แยกจากการรออันดับ ไม่สัญญาว่าครบ 7 วันแล้วทุกหน้าเปลี่ยนสถานะ
แหล่งอ้างอิงและเงื่อนไขของตัวอย่าง
- Google: robots.txt ใช้ทำอะไร
- Google: การบล็อกด้วย noindex
- Google: ข้อกำหนด robots.txt
- Google: รายงาน robots.txt
- Google: robots meta และ HTTP header
ทบทวนเอกสารและตรวจ robots.txt สาธารณะซ้ำวันที่ 20 ตุลาคม 2026 ส่วนภาพหน้าตั้งค่าถ่ายใหม่วันที่ 20 ตุลาคม 2026 ข้อความ robots.txt และหน้าตั้งค่าเป็นข้อมูลของ DAYZERO จริง ส่วนแผนภาพสร้างด้วย GPT และกรณีตัวอย่างเป็นสมมติ ไม่ใช่ผลลูกค้าหรือหลักฐานว่าอันดับเพิ่ม
ไม่แน่ใจว่าหน้าสำคัญถูกบล็อกตรงไหน?
ส่ง URL และเป้าหมายว่าอยากให้ค้นพบหรือไม่ พร้อมเหตุผลที่เห็นใน Search Console เพื่อจัดลำดับตรวจและส่งงานแก้ให้ตรงจุด บริการ SEO ของ DAYZERO