พบหลาย URL ที่ดูเหมือนหน้าเดียวกัน อย่าเพิ่งตัดพารามิเตอร์ทั้งหมด บางตัวใช้วัดแคมเปญ บางตัวเปลี่ยนสินค้า และบางตัวพาไปหน้าถัดไป คู่มือนี้ช่วยแยกกรณี เลือกวิธีแก้ และตรวจผลจากเว็บจริงกับ GSC โดยรักษาการใช้งานของลูกค้า
URL ซ้ำคืออะไร และควรแก้อะไรก่อน
URL ซ้ำ คือหลายที่อยู่ที่แสดงเนื้อหาหลักเหมือนกันหรือใกล้เคียงกัน เช่น บทความเดียวเปิดได้ทั้ง URL ปกติและ URL ที่ติด UTM โดยทั่วไปการมีหน้าซ้ำไม่ได้แปลว่าเป็นสแปมหรือถูกลงโทษอัตโนมัติ แต่ทำให้การเลือกหน้าหลัก ลิงก์ และการติดตามผลซับซ้อนขึ้น
ก่อนแก้ ถามสองข้อ: พารามิเตอร์เปลี่ยนเนื้อหาหรือไม่ และหน้านั้นมีเหตุผลให้คนค้นหาเจอแยกต่างหากหรือไม่ ถ้าเปลี่ยนรายการสินค้า เปลี่ยนภาษา หรือเปิดหน้าที่ 2 อย่าตัดทิ้งเพียงเพราะ URL มีเครื่องหมาย ?
- เริ่มจาก URL ที่เกี่ยวกับบริการ สินค้า หรือหน้าเข้าเว็บสำคัญ แล้วเลือกตัวอย่างจากแต่ละรูปแบบมาทดสอบ
- ถ้าเว็บสร้าง URL ตัวกรองจำนวนมากจน crawl หน้าสำคัญช้า ให้ตรวจปริมาณและกฎการสร้าง URL ร่วมกับทีมเว็บ
- ถ้าบทความคนละเรื่องแย่งคำค้นเดียวกัน ต้องตรวจเจตนาและเนื้อหาอีกแบบ อ่าน คู่มือ Keyword Cannibalization
หลักการเลือก Canonical, Redirect และ Sitemap อยู่ใน คู่มือจัดสัญญาณ URL ส่วนบทความนี้เน้นการแยกกรณีใน CMS และตรวจว่าตั้งค่าตรงวัตถุประสงค์จริง
ต้องการให้ช่วยดู SEO ของเว็บไซต์คุณ? ดู บริการรับทำ SEO ของ DAYZERO
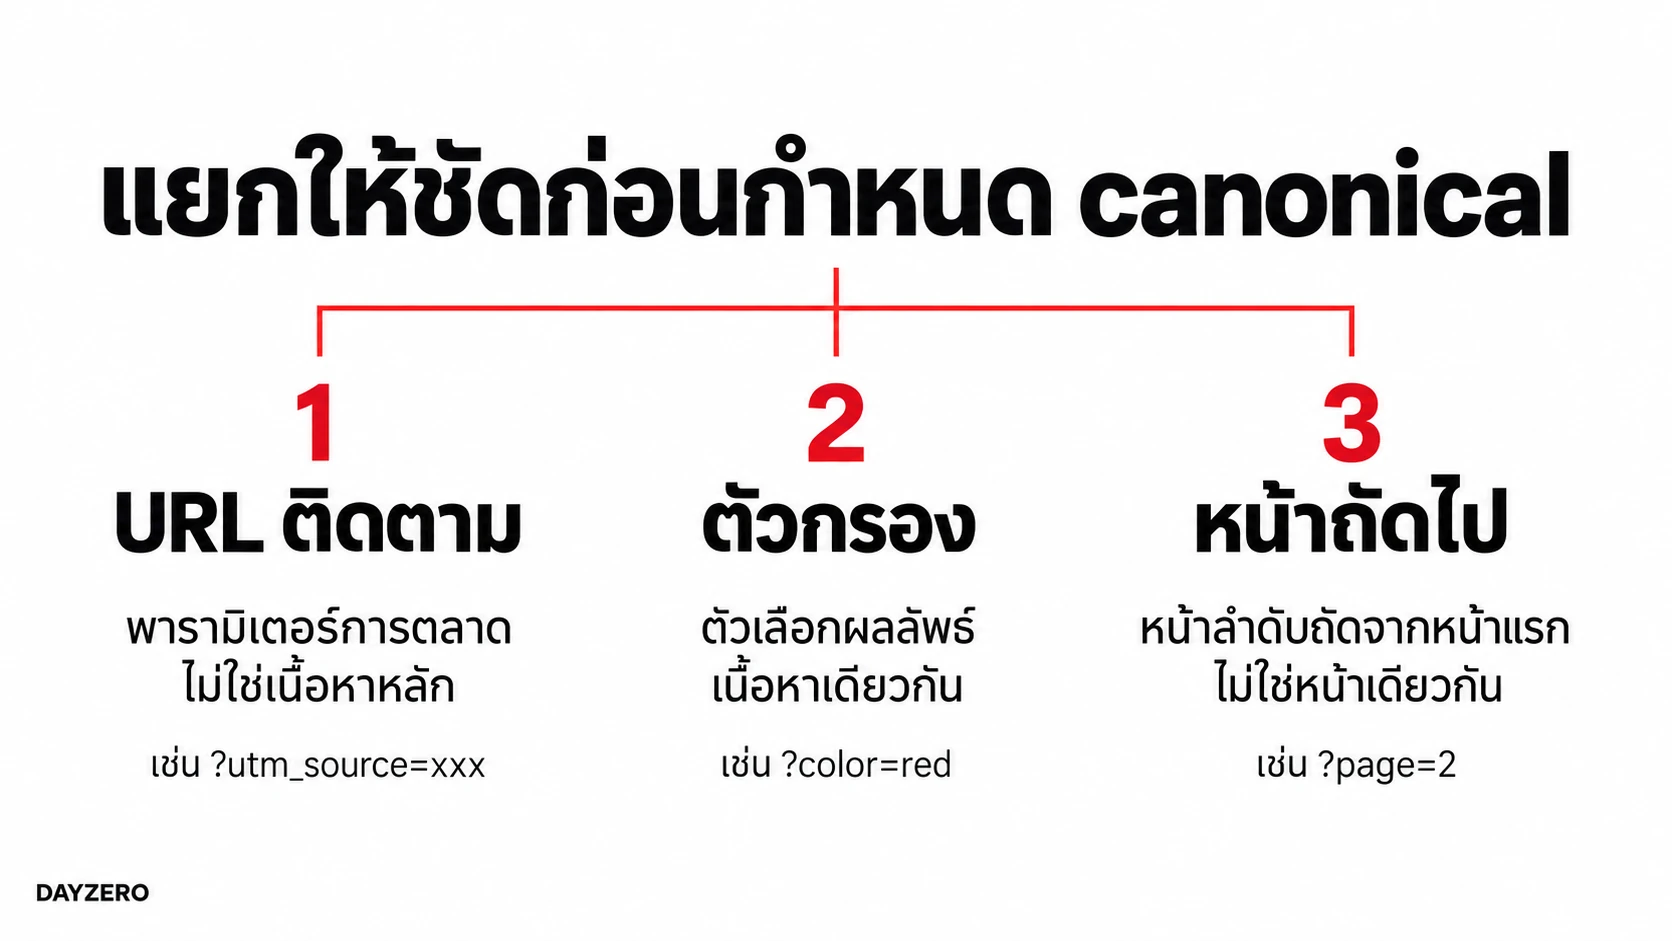
แยก UTM การเรียงสินค้า ตัวกรอง และหน้าที่ 2
| รูปแบบ URL | คำถามที่ต้องตอบ |
|---|---|
| ?utm_source=mail | เนื้อหาเดิม? เก็บการวัดผลแล้วหรือยัง? |
| ?sort=price | แค่เรียงใหม่ หรือรายการเปลี่ยน? |
| ?color=green | มีเจตนาค้นหาและหน้าที่มีประโยชน์แยกไหม? |
| ?page=2 | มีรายการถัดไปที่หน้าแรกไม่มีไหม? |
| /print/ หรือ path ซ้ำ | ยังต้องเปิดรูปแบบนี้หรือย้ายได้? |
ตัวอย่างสมมติร้านเสื้อผ้า: การเรียงราคาจากต่ำไปสูงอาจแสดงสินค้าเดิม ขณะที่ “เสื้อเชิ้ตสีเขียว” อาจเป็นกลุ่มสินค้าที่ลูกค้าค้นหา แต่ไม่ได้แปลว่าทุกชุดสี–ไซซ์–ราคาเป็นหน้าที่ควร index ต้องดูความต้องการและคุณภาพของหน้าเป็นรายกลุ่ม
หน้า 2 ของรายการอาจมีสินค้าที่หน้า 1 ไม่มี จึงไม่ใช่หน้าซ้ำเพียงเพราะชื่อหมวดและส่วนหัวเหมือนกัน ส่วนภาษาไทยกับภาษาอังกฤษที่แปลเนื้อหาหลักจริงก็ไม่ควรถูกรวมเป็นภาษาเดียว อ่าน SEO เว็บไซต์หลายภาษา เมื่อมีหลายตลาด
ทำรายการ URL จากระบบจริง แล้วเทียบเนื้อหา
รวมตัวอย่างจาก CMS, sitemap, ลิงก์ในเว็บไซต์, รายงาน GSC, Analytics และ log ที่มีสิทธิ์ใช้ แต่ละแหล่งมีขอบเขตต่างกัน Sitemap ไม่ใช่รายชื่อ URL ทุกแบบ และจำนวนหน้าที่พบมากกว่าจำนวนบทความไม่ได้พิสูจน์ปัญหาเอง
- คู่ URL: URL ที่ต้องการใช้เป็นหลัก กับ URL ที่สงสัยว่าซ้ำ พร้อมที่มาของตัวอย่าง
- เนื้อหาหลัก: เทียบสินค้า ข้อมูลบริการ ข้อความหลัก และสิ่งที่ผู้ใช้ทำได้ อย่าดูแค่ title/H1
- ผลเปิดจริง: HTTP status, ปลายทางสุดท้าย, canonical ใน HTML และข้อจำกัด index
- หน้าที่: ติดตามแคมเปญ จัดลำดับ กรองข้อมูล แบ่งหน้า หรือเส้นทางเก่า
ถ้าเว็บแสดงเนื้อหาด้วย JavaScript ให้ตรวจหน้าที่แสดงจริงด้วย การอ่าน HTML ต้นทางอย่างเดียวอาจเห็นข้อมูลไม่ครบ เริ่มจากกลุ่มเล็กที่ตรวจได้ แล้วจึงทดสอบกฎในจำนวน URL ที่มากขึ้นโดยไม่เดาว่าตัวอย่างเดียวครอบคลุมทั้งเว็บ
ทดสอบกฎด้วย URL ที่ควรเหมือน และ URL ที่ต้องต่าง
ตัวอย่างสมมติต่อไปนี้ใช้กำหนดงานตรวจ ไม่ใช่ผลทดสอบร้านจริง ให้จดผลที่คาดหวังก่อนรันกฎ แล้วเทียบกับรายการที่แสดงจริง
- สลับลำดับ: ?color=green&size=m กับ ?size=m&color=green ถ้าระบบตีความเหมือนกัน ต้องได้สินค้าชุดเดียวกัน และส่งสัญญาณหน้าหลักสอดคล้องกัน ให้เมนูสร้างรูปแบบเดียวอย่างสม่ำเสมอ
- ค่าตั้งต้น: ?page=1 อาจเหมือน URL หมวดปกติ แต่ ?page=2 ต้องยังเปิดสินค้าชุดถัดไปได้ อย่าให้กฎตัดพารามิเตอร์รวมทั้งสองกรณี
- ชุดที่ไม่มีจริง: ตัวกรองขัดกันหรือเลขหน้าที่เกินรายการต้องไม่สร้างหน้า 200 ว่างไม่สิ้นสุด ตรวจสถานะ 404 ที่ URL นั้น โดยยังช่วยให้ผู้ใช้กลับไปแก้ตัวกรองได้
ค่าพารามิเตอร์ภาษาไทยไม่ได้ใช้ไม่ได้โดยอัตโนมัติ ต้องเข้ารหัส percent encoding ให้ถูกต้องและทดสอบหลังคัดลอกลิงก์ ระวังการเข้ารหัสซ้ำจน % กลายเป็น %25 แล้วระบบค้นหาคนละค่า ส่วนข้อตกลงชื่อ UTM ภาษาอังกฤษเป็นเรื่องความสม่ำเสมอในการวัดผล ไม่ใช่ข้อห้ามใช้ภาษาไทยของ Google
URL ติด UTM: รักษาการวัดผลและระบุหน้าหลัก
ถ้า UTM เปลี่ยนเฉพาะแหล่งแคมเปญและเนื้อหาหลักยังเหมือนเดิม ให้ตรวจว่า canonical ชี้ไป URL ปกติที่ถูกต้อง ลิงก์ภายในและ sitemap ใช้ URL นั้น ส่วนลิงก์จากแคมเปญยังติด UTM ตามแผนการวัดผลได้
ตัวอย่างโค้ดต่อไปนี้เป็นรูปแบบอธิบายสำหรับหน้าที่เนื้อหาเดียวกัน ไม่ใช่คำสั่งให้นำไปวางทุกหน้าของเว็บไซต์ ต้องเปลี่ยน href ให้ตรงหน้าและหลีกเลี่ยง canonical ซ้ำจากหลายปลั๊กอิน
<link rel="canonical" href="https://example.com/guide/">อย่าส่งต่อเพื่อตัด query string ทั้งหมดโดยไม่ทดสอบ เพราะอาจลบตัวกรอง ภาษา ข้อมูลแคมเปญ หรือข้อมูลที่ระบบจองต้องใช้ ถ้าจะเปลี่ยนพฤติกรรม URL ให้กำหนดรายชื่อพารามิเตอร์ที่เก็บและที่ตัด พร้อมทดลองเส้นทางของลูกค้าและผลรับข้อมูล
UTM มีความไวต่ออักษรใหญ่–เล็ก จึงควรใช้ข้อตกลงชื่อ source/medium/campaign เดียวกัน ตรวจรายงาน acquisition และการรับข้อมูลด้วยสิทธิ์ที่มี เอกสาร GA4 ปัจจุบันระบุว่า UTM ไม่แสดงใน dimension Landing page + query string และ Page path + query string การไม่เห็น UTM ในสองช่องนี้จึงไม่พิสูจน์ว่าเว็บไซต์ตัดมันทิ้ง
ตัวอย่าง DAYZERO: URL ปกติเทียบกับ UTM
วันที่ 14 ตุลาคม 2026 ตรวจหน้า 301 Redirect ของ DAYZERO โดยเปิดแบบไม่ล็อกอิน แล้วเปรียบเทียบกับ URL เดียวกันที่เพิ่ม utm_source=seo_qa, utm_medium=manual_test และ utm_campaign=duplicate_url_check
| ผลตรวจสาธารณะ | ที่พบ |
|---|---|
| URL ปกติและ UTM | ทั้งคู่ตอบ HTTP 200 |
| เนื้อหาบทความหลัก | เหมือนกันในผลที่บันทึก |
| canonical ของทั้งคู่ | ชี้ URL ปกติ /301-redirect/ |
| URL สุดท้ายของตัวอย่าง UTM | ยังมี query string |
ผลนี้แสดงเพียงพฤติกรรมของหน้าและ canonical ที่เว็บส่งมา ไม่ยืนยันว่า Google เลือก URL ไหน ไม่ยืนยัน index หรือการรับข้อมูล GA4 และไม่ใช่ผลเพิ่มอันดับของลูกค้า การทดสอบไม่ได้เปลี่ยนกฎเว็บไซต์
ใช้รูปแบบนี้เป็นหลักฐานส่งงานได้: บันทึก URL ที่ขอ ผลเปิดจริง เวลา วิธีตรวจ และสิ่งที่ยังตรวจไม่ได้ แยกผลสาธารณะออกจากรายงานในเครื่องมือที่ต้องมีสิทธิ์
ตัวกรองและ sort: เลือกว่าจะให้ค้นหาเจอหรือไม่
ตัวกรองมีสองงานที่ต้องแยก: จัดการว่าหน้าไหนควรอยู่ในผลค้นหา และลด URL ที่กินทรัพยากร crawl การใส่ canonical อย่างเดียวไม่ใช่วิธีหยุดการ crawl URL จำนวนมากทันที
- แค่เรียงข้อมูลเดิม: ตรวจความเหมือนของเนื้อหาและหน้าหลักที่เหมาะสมก่อนใช้ canonical ไม่ชี้ทุกหมวดไปหน้าแรกของเว็บ
- หมวดกรองที่ต้องการค้นหา: มีรายการและข้อมูลตอบความต้องการจริง มี URL สม่ำเสมอ ลิงก์เข้าถึงได้ และไม่ชนกับหน้าหมวดที่มีอยู่
- ชุดผสมที่ไม่ต้องการ: ให้ทีมตรวจทั้งสถานะ index ปัจจุบันและต้นทุน crawl ก่อนเลือกกฎ อย่าสับสน noindex กับ robots.txt
ตัวอย่างสมมติร้านที่มีสินค้า 3 สี 5 ไซซ์และช่วงราคาอีกหลายระดับ: การเปิดทุกชุดผสมอาจสร้างทางเข้ามากแต่ไม่เพิ่มประโยชน์ ให้เลือกกลุ่มที่ธุรกิจรักษาข้อมูลได้จริง ส่วน URL ชุดที่ไม่มีผลลัพธ์หรือไม่มีอยู่จริงควรตรวจสถานะ 404 ตามแนวทาง Google ไม่ส่งทุกกรณีไปหน้าแรก
หากหน้าอยู่ในดัชนีแล้วและต้องอ่าน noindex อย่าปิด crawl จน Google อ่านคำสั่งไม่ได้ ส่วน robots.txt ใช้ควบคุม crawl และไม่รับรองการนำ URL ออกจากผลค้นหา การกำหนดกฎจริงต้องทดสอบ pattern กับ URL ที่ควรเก็บด้วย อ่าน วิธีใช้ robots.txt กับ noindex
หน้า 2 ไม่ใช่หน้า 1: ระวัง canonical ของรายการ
หน้าถัดไปของหมวดหรือบทความอาจมีข้อมูลใหม่สำหรับผู้ใช้ ให้แต่ละหน้ามี URL ที่แยกกันและ canonical ของตัวเอง ไม่ตั้ง page=2, page=3 และทุกหน้าชี้ page=1 เพราะชื่อหมวดเหมือนกัน
ให้ Google พบลิงก์ที่มี href ไปหน้าถัดไปได้จริง ไม่อาศัยปุ่ม “โหลดเพิ่ม” ที่ต้องคลิกอย่างเดียว ตรวจว่าผู้ใช้กลับไปหน้าเดิม แชร์ URL และเปิดหน้า 2 โดยตรงได้ ถ้าใช้ JavaScript ควรตรวจรายการที่แสดงหลังเปิด URL นั้นด้วย
ส่วน #page=2 เป็น fragment ไม่ควรใช้เป็นทางเดียวของหน้าแบ่งรายการที่ต้องการให้ Google crawl เป็นหน้าแยก ส่วนตัวกรองที่ไม่ต้องการให้ค้นหาอาจใช้กลไกต่างกัน จึงต้องแยก pagination ออกจาก filter ตั้งแต่รายการงาน
URL ซ้ำจาก CMS: แก้ต้นเหตุและลิงก์ที่สร้างซ้ำ
WordPress หรือ CMS อื่นอาจสร้าง path สำรอง หน้า print หมวด tag และ URL ของสื่อหลายแบบ แต่ชื่อชนิดหน้าไม่ได้ตัดสินว่าเป็นปัญหา ให้ตรวจเนื้อหา หน้าที่ และการใช้งานก่อนปิดหรือย้าย
ถ้าจะเลิกใช้ path เก่าจริงและมีหน้าทดแทนตรงเรื่อง ให้ใช้ Redirect ที่ตรวจแล้ว ถ้ายังต้องเปิดหลายรูปแบบที่เนื้อหาเหมือนกัน ให้ประเมิน canonical ไปหน้าหลัก การตั้ง noindex ใช้เมื่อไม่ต้องการให้หน้านั้นอยู่ในผลค้นหา ไม่ใช่วิธีรวมสัญญาณ canonical
- ตรวจเมนู breadcrumb รายการบทความ และลิงก์ใน template ว่ายังสร้าง URL ที่เลิกใช้หรือไม่
- ตรวจ canonical ว่ามีหนึ่งค่าที่ตั้งใจใช้ ไม่ถูกธีมและปลั๊กอินออกค่าคนละ URL
- sitemap ส่งหน้าหลักที่พร้อม index และลิงก์ภายในไป URL นั้นโดยตรง
- ทดสอบพารามิเตอร์ที่เกี่ยวกับการจอง ตะกร้า ภาษา และแคมเปญ ก่อนใช้กฎรวม
วิธีติดตั้งและตรวจการส่งต่ออยู่ใน คู่มือ 301 Redirect ส่วนรายการ sitemap ใช้ วิธีตรวจ XML Sitemap ถ้าเป็นการย้ายทั้งเว็บ ให้มีแผนก่อน–หลังเปิดตาม เช็กลิสต์เปลี่ยนเว็บไซต์ SEO
ตรวจ canonical ที่เว็บประกาศ กับที่ Google เลือก
ตรวจแบบไม่ล็อกอินก่อน: เปิด URL ปกติและตัวอย่าง query, เทียบเนื้อหาหลัก, HTTP และ canonical รวมถึงลิงก์และ sitemap หลังเปลี่ยนกฎให้บันทึกผลก่อน–หลังในเงื่อนไขเดียวกัน
ใน GSC ที่มีสิทธิ์ ให้ตรวจ URL และอ่านรายงานที่จัดทำดัชนีแล้ว โดยเทียบ User-declared canonical กับ Google-selected canonical การทดสอบสดไม่ได้บอกล่วงหน้าว่า Google จะเลือก canonical ไหน ถ้าตรวจได้เฉพาะเว็บสาธารณะ ให้รายงานเพียง canonical ที่เว็บประกาศ
ถ้า Google เลือกต่างจากที่ตั้งใจ ให้ตรวจความเหมือนของเนื้อหา ปลายทางที่ยังเปิดได้ การออก canonical ซ้ำ ลิงก์ภายใน sitemap และ hreflang ที่ขัดกัน ไม่เริ่มด้วยส่งคำขอซ้ำจำนวนมาก เพราะคำขอไม่ได้แทนการแก้สัญญาณ
เครื่องมือ URL Parameters เดิมของ GSC ยกเลิกตั้งแต่ปี 2022 จึงไม่ควรใช้คู่มือที่ให้เข้าเมนูนั้นเป็นขั้นตอนปัจจุบัน ผลการตรวจสดผ่านไม่ได้รับรองการ index หรืออันดับ
สถานะ Duplicate ใน GSC ไม่ได้ต้องแก้ทุก URL
- Alternate page with proper canonical tag: หน้าทางเลือกชี้หน้าหลักที่ index แล้วถูกต้อง จึงไม่ต้องพยายามทำให้ทุกเวอร์ชัน index เพิ่ม
- Duplicate without user-selected canonical: เว็บไม่ได้ระบุหน้าหลัก และ Google เลือกให้อีก URL ตรวจว่าหน้านั้นตรงเจตนาหรือไม่ ก่อนตัดสินว่ามีปัญหา
- Duplicate, Google chose different canonical than user: เปิดเทียบทั้ง URL ที่ตรวจ หน้าที่เว็บระบุ และหน้าที่ Google เลือก ถ้าเนื้อหาต่างจริง การบังคับ canonical เดิมซ้ำไม่ใช่คำตอบ
ตัวอย่างสมมติ: URL ติด UTM ไม่ index แต่หน้าบทความปกติถูกเลือกตรงแผน ถือว่าคนละกรณีกับหน้าสินค้าหลักที่ถูกจับรวมกับสินค้าอีกชนิด เป้าหมายคือให้หน้าที่ถูกต้องค้นหาเจอ ไม่ใช่ทำให้จำนวน “ไม่จัดทำดัชนี” เป็นศูนย์ ดู ความหมายสถานะจาก GSC
ส่งงานด้วยผลตรวจ ไม่ใช่คำว่า “แก้ URL ซ้ำแล้ว”
| สิ่งที่ส่งมอบ | ผลที่ต้องรับ |
|---|---|
| กฎแยก URL | เหตุผลเก็บ ย้าย รวม หรือไม่ index |
| ผลทดสอบคู่ URL | เนื้อหา status canonical และ query ที่ยังใช้ได้ |
| ลิงก์และ sitemap | ตัวอย่าง URL ตรงแผน ไม่ย้อนกลับไปแบบเก่า |
| ข้อมูลหลังแก้ | ผล GSC/crawl/การรับข้อมูล หรือระบุรอตรวจ |
ให้เจ้าของเว็บตรวจเส้นทางใช้งานสำคัญ ทีมเว็บตรวจการสร้าง URL และทีม SEO ตรวจหน้าหลักกับรายการ index ถ้าการรับข้อมูลแคมเปญยังไม่ยืนยัน ให้มีเจ้าของงานและสถานะรอ อย่าใส่ผ่านเพราะ canonical ใน HTML ถูกอย่างเดียว
ติดตามกลุ่ม URL ที่แก้ ไม่สรุปว่าอันดับเพิ่มจากจำนวนหน้าซ้ำที่ลดลงทันที แยกการรวม URL การ crawl การค้นพบ และการรับคำถามจริงตาม แผนตรวจ Technical SEO
Canonical Tag: เสนอหน้าหลักโดยไม่ส่งต่อผู้ใช้
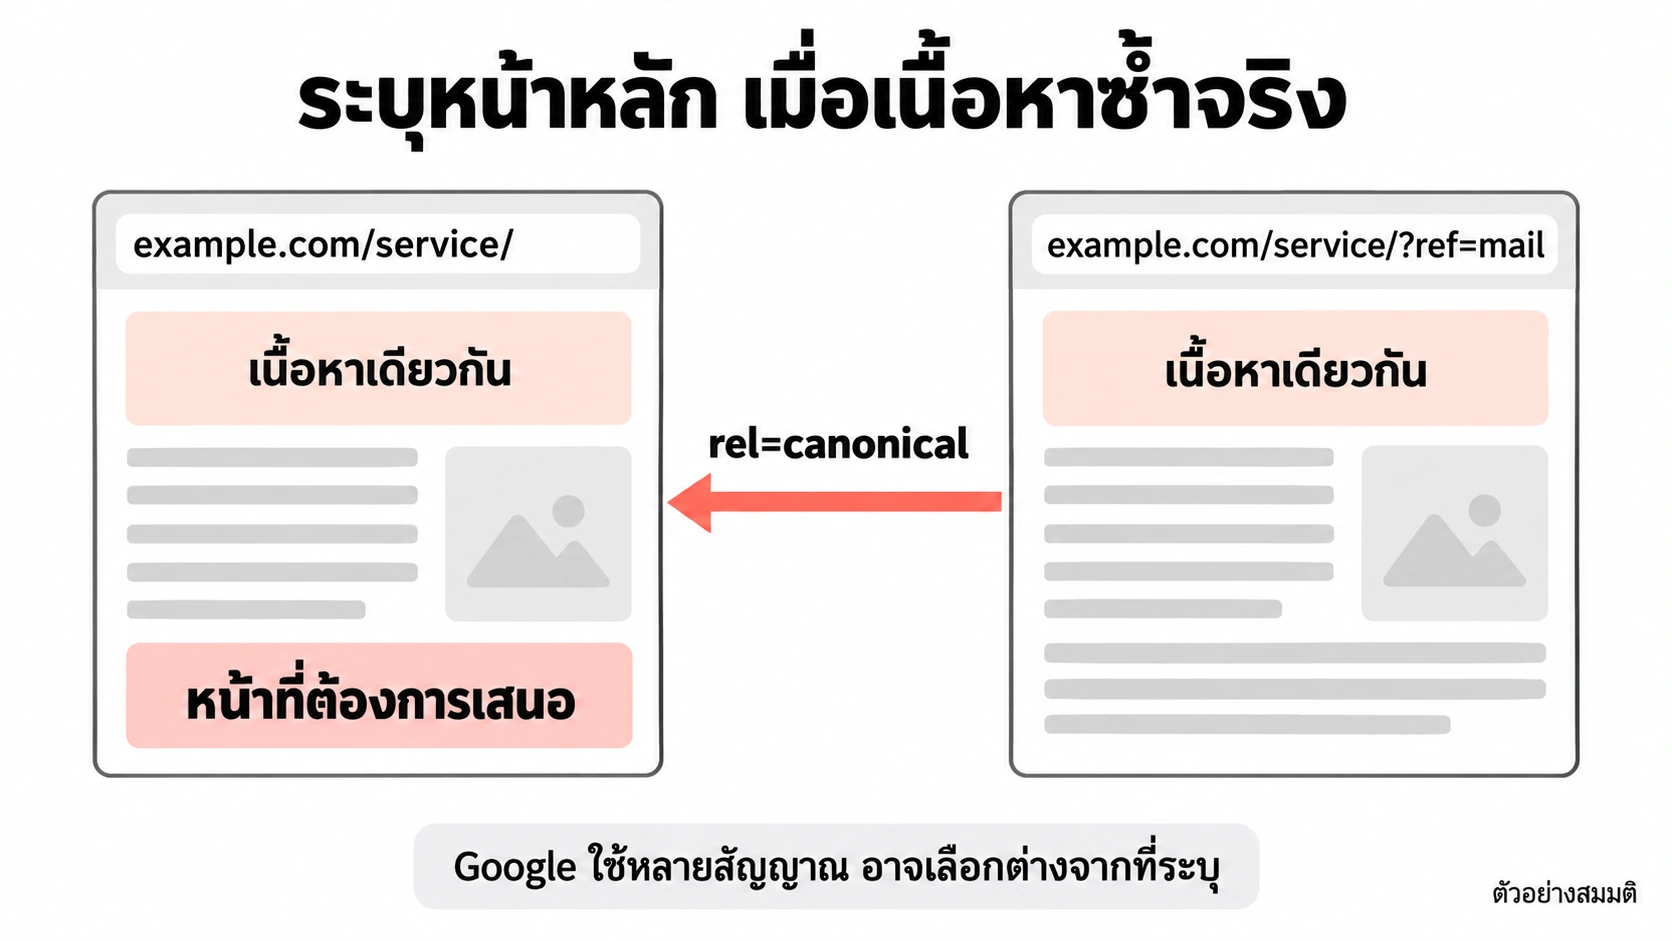
สำหรับ HTML ใส่ rel=”canonical” ในส่วน head และใช้ URL เต็มของหน้าตัวแทน หน้าตัวแทนเองควรอ้างอิง URL ของตัวเองด้วย ตรวจว่าปลายทางเปิดได้ มีเนื้อหาที่เหมาะ และไม่ชี้ไปหน้าที่ต้องล็อกอินหรือหน้าที่ตั้งใจไม่ให้ค้นหา
ตรวจผลที่เว็บไซต์แสดงจริง เพราะธีมและปลั๊กอินอาจสร้างแท็กอยู่แล้ว การเพิ่มซ้ำโดยไม่ตรวจอาจได้คำแนะนำขัดกัน ลิงก์ภายในและ sitemap ควรใช้ URL ที่เลือก ไม่เสนอ URL คนละตัวสำหรับเนื้อหาเดียวกัน
Canonical เป็นสัญญาณ ไม่ใช่คำสั่งบังคับ Google อาจเลือกต่างจากที่ประกาศ และไม่ควรชี้ทุกหน้าไปหน้าแรก ห้ามใช้ noindex หรือ robots.txt เป็นวิธีแทนการเลือกรวม URL ภายในเว็บไซต์
ตัวอย่างแท็ก และจุดที่ต้องตรวจใน HTML จริง
ตัวอย่างต่อไปนี้เป็นโค้ดอธิบาย ไม่ใช่แท็กที่ติดตั้งในบทความ ให้ทีมพัฒนาวางแท็กจริงใน head ของเทมเพลตที่เกี่ยวข้อง และเปลี่ยนโดเมนตัวอย่างเป็น URL ที่เลือกแล้ว
<link rel="canonical"
  href="https://example.com/service/">
เปิดซอร์สของหน้าเผยแพร่แล้วค้นหา rel=”canonical” ตรวจ href ให้ตรง URL เต็ม รวม HTTPS ชื่อโฮสต์ และ path ตามโครงสร้างที่ใช้ หากเว็บใช้ JavaScript ให้ตรวจ DOM หลังแสดงผลด้วยว่าไม่ได้เปลี่ยน canonical เป็นอีก URL Google แนะนำให้ระบุใน HTML ต้นทางและไม่ให้ JavaScript เปลี่ยนค่า ถ้าจำเป็นต้องสร้างด้วย JavaScript ให้หลีกเลี่ยงการประกาศคนละค่าระหว่างสองขั้นตอน
แท็กที่อยู่ใน body หรือโค้ดที่แสดงเป็นข้อความอย่างตัวอย่างนี้ไม่ได้ทำหน้าที่เป็น canonical ใน head ส่วนไฟล์ PDF ที่ต้องเสนอหน้า HTML เป็นตัวแทน สามารถใช้ Link HTTP response header ตามข้อกำหนดของ Google ได้ ให้ผู้ดูแลเซิร์ฟเวอร์ตรวจ header จริง ไม่วางแท็ก HTML ลงใน PDF
หน้าแบ่งรายการและฉบับต่างภาษา: อย่ารวมผิดหน้า
หน้ารายการ ?page=2 มีรายการต่อจากหน้าแรก จึงไม่ควร canonical ทุกหน้าไป ?page=1 ให้แต่ละหน้าในลำดับมี URL ของตัวเองและ canonical ของหน้านั้น พร้อมลิงก์ที่ตามไปหน้าถัดไปได้ Google ไม่ใช้ rel=”next” และ rel=”prev” เพื่อเข้าใจลำดับหน้าอีกแล้ว
ถ้าแปลเนื้อหาหลักจริงเป็นไทยและญี่ปุ่น Google ไม่ถือว่าสองหน้านั้นซ้ำกันเพียงเพราะเป็นฉบับแปล ใช้ canonical ในภาษาเดียวกันและเชื่อมฉบับภาษาด้วย hreflang อย่างเหมาะสม แต่การแปลแค่เมนูโดยเนื้อหาหลักยังเหมือนเดิมเป็นอีกกรณีหนึ่ง ดู วิธีตรวจ hreflang และ URL ของแต่ละภาษา ก่อนรวม URL
หากพาร์ทเนอร์นำบทความไปเผยแพร่ซ้ำ อย่าถือว่า canonical ข้ามโดเมนจะป้องกันการแข่งใน Search ได้แน่นอน Google ไม่แนะนำวิธีนี้สำหรับการกันฉบับเผยแพร่ซ้ำออกจาก Search วิธีที่มีประสิทธิภาพกว่าคือให้พาร์ทเนอร์บล็อกการจัดทำดัชนีฉบับของตน โดยตกลงกับผู้เผยแพร่ก่อน
คำถามเรื่อง Duplicate Content และพารามิเตอร์
URL มี ? ทุกหน้าต้องแก้ไหม?
ไม่ใช่ แยกว่าติดตาม เปลี่ยนเนื้อหา กรอง หรือแบ่งหน้า แล้วตัดสินจากหน้าที่และเนื้อหา ไม่ใช่รูปแบบ URL อย่างเดียว
ใส่ canonical แล้ว Google ต้องใช้หน้านั้นไหม?
ไม่รับรอง เป็นสัญญาณที่เว็บส่งให้ Google ต้องตรวจความสอดคล้องและผลเลือกจริงในรายงานที่มีสิทธิ์
ควรลบ UTM เพื่อให้ SEO ดีขึ้นไหม?
อย่าลบเหมารวม ถ้าเนื้อหาเดิมให้จัด canonical และลิงก์ ขณะรักษาการวัดผลที่ต้องใช้ การเปลี่ยน query ต้องทดสอบการรับข้อมูล
หน้า 2 ชี้ canonical ไปหน้า 1 ได้ไหม?
ถ้ามีรายการคนละชุด ให้แต่ละหน้ามี URL และ canonical ของตัวเอง ไม่รวมทุกหน้าเพราะชื่อหมวดเหมือนกัน
แปลบทความเป็นไทยกับอังกฤษนับว่าซ้ำไหม?
ถ้าแปลเนื้อหาหลักจริง ไม่ใช่การมีหน้าหลักเดียวกันเพียงเพราะเรื่องเดียวกัน แต่ถ้าเปลี่ยนแค่เมนูและเนื้อหาหลักเดิม ต้องประเมินอีกครั้ง
แหล่งข้อมูลและขอบเขตหลักฐาน
ตรวจเอกสาร Google และเปรียบเทียบบทความภาษาไทยกับญี่ปุ่นเพิ่มเติมวันที่ 20 ตุลาคม 2026 (ผลตรวจสาธารณะเดิมในตารางยังระบุวันที่ 14 ตุลาคมตามจริง) วิธีแบ่งกลุ่ม URL และรายการส่งงานเป็นแนวทางทำงานของ DAYZERO ที่ต้องปรับตามระบบจริง ตัวอย่างร้านค้าเป็นสถานการณ์สมมติ ไม่มีตัวเลขผลลูกค้าหรือการรับรองอันดับ
- Google: โครงสร้าง URL และการเข้ารหัส
- Google: Canonicalization
- Google: รวม URL ซ้ำ
- Google: Faceted navigation
- Google: ページ分け(日本語)
- GSC: URL Inspection
- Google: URL Parameters tool廃止
- GA4: Campaign URL
ภาพในหน้านี้เป็นคำอธิบายสร้างด้วย GPT แยกจากผลสาธารณะที่บันทึกในตาราง ผลสาธารณะไม่แทน Google-selected canonical, index หรือการรับข้อมูล Analytics
มี URL หลายแบบ แต่ยังไม่รู้ว่าควรเก็บหน้าไหน?
ส่ง URL ตัวอย่าง หน้าหลักที่ต้องการ และหน้าที่ของพารามิเตอร์ เราจะเริ่มจากตรวจเนื้อหากับทางใช้งาน แล้วกำหนดรายการแก้และหลักฐานส่งงาน บริการ SEO ของ DAYZERO